谷岡廣樹《深度學習入門教室》閱讀筆記
多年來,我反覆研讀 93 本書,親手淬鍊成閱讀筆記。為了予其安放之所,我築起了這座書影懸浮的【無涯殿】——願它們承載的思想,比我活得更久。
謝謝你來到這裏。此刻,你正駐足於這座書庫的第 82 份筆記——
谷岡廣樹、康鑫《深度學習入門教室:6 堂基礎課程 + Python 實作練習,Deep Learning、人工智慧、機器學習的理論和應用全圖解》
English translation here.
閱畢全篇可領贈品。請享受閱讀。
Listen to the deep dive of these notes by Gemini Notebook (In English).
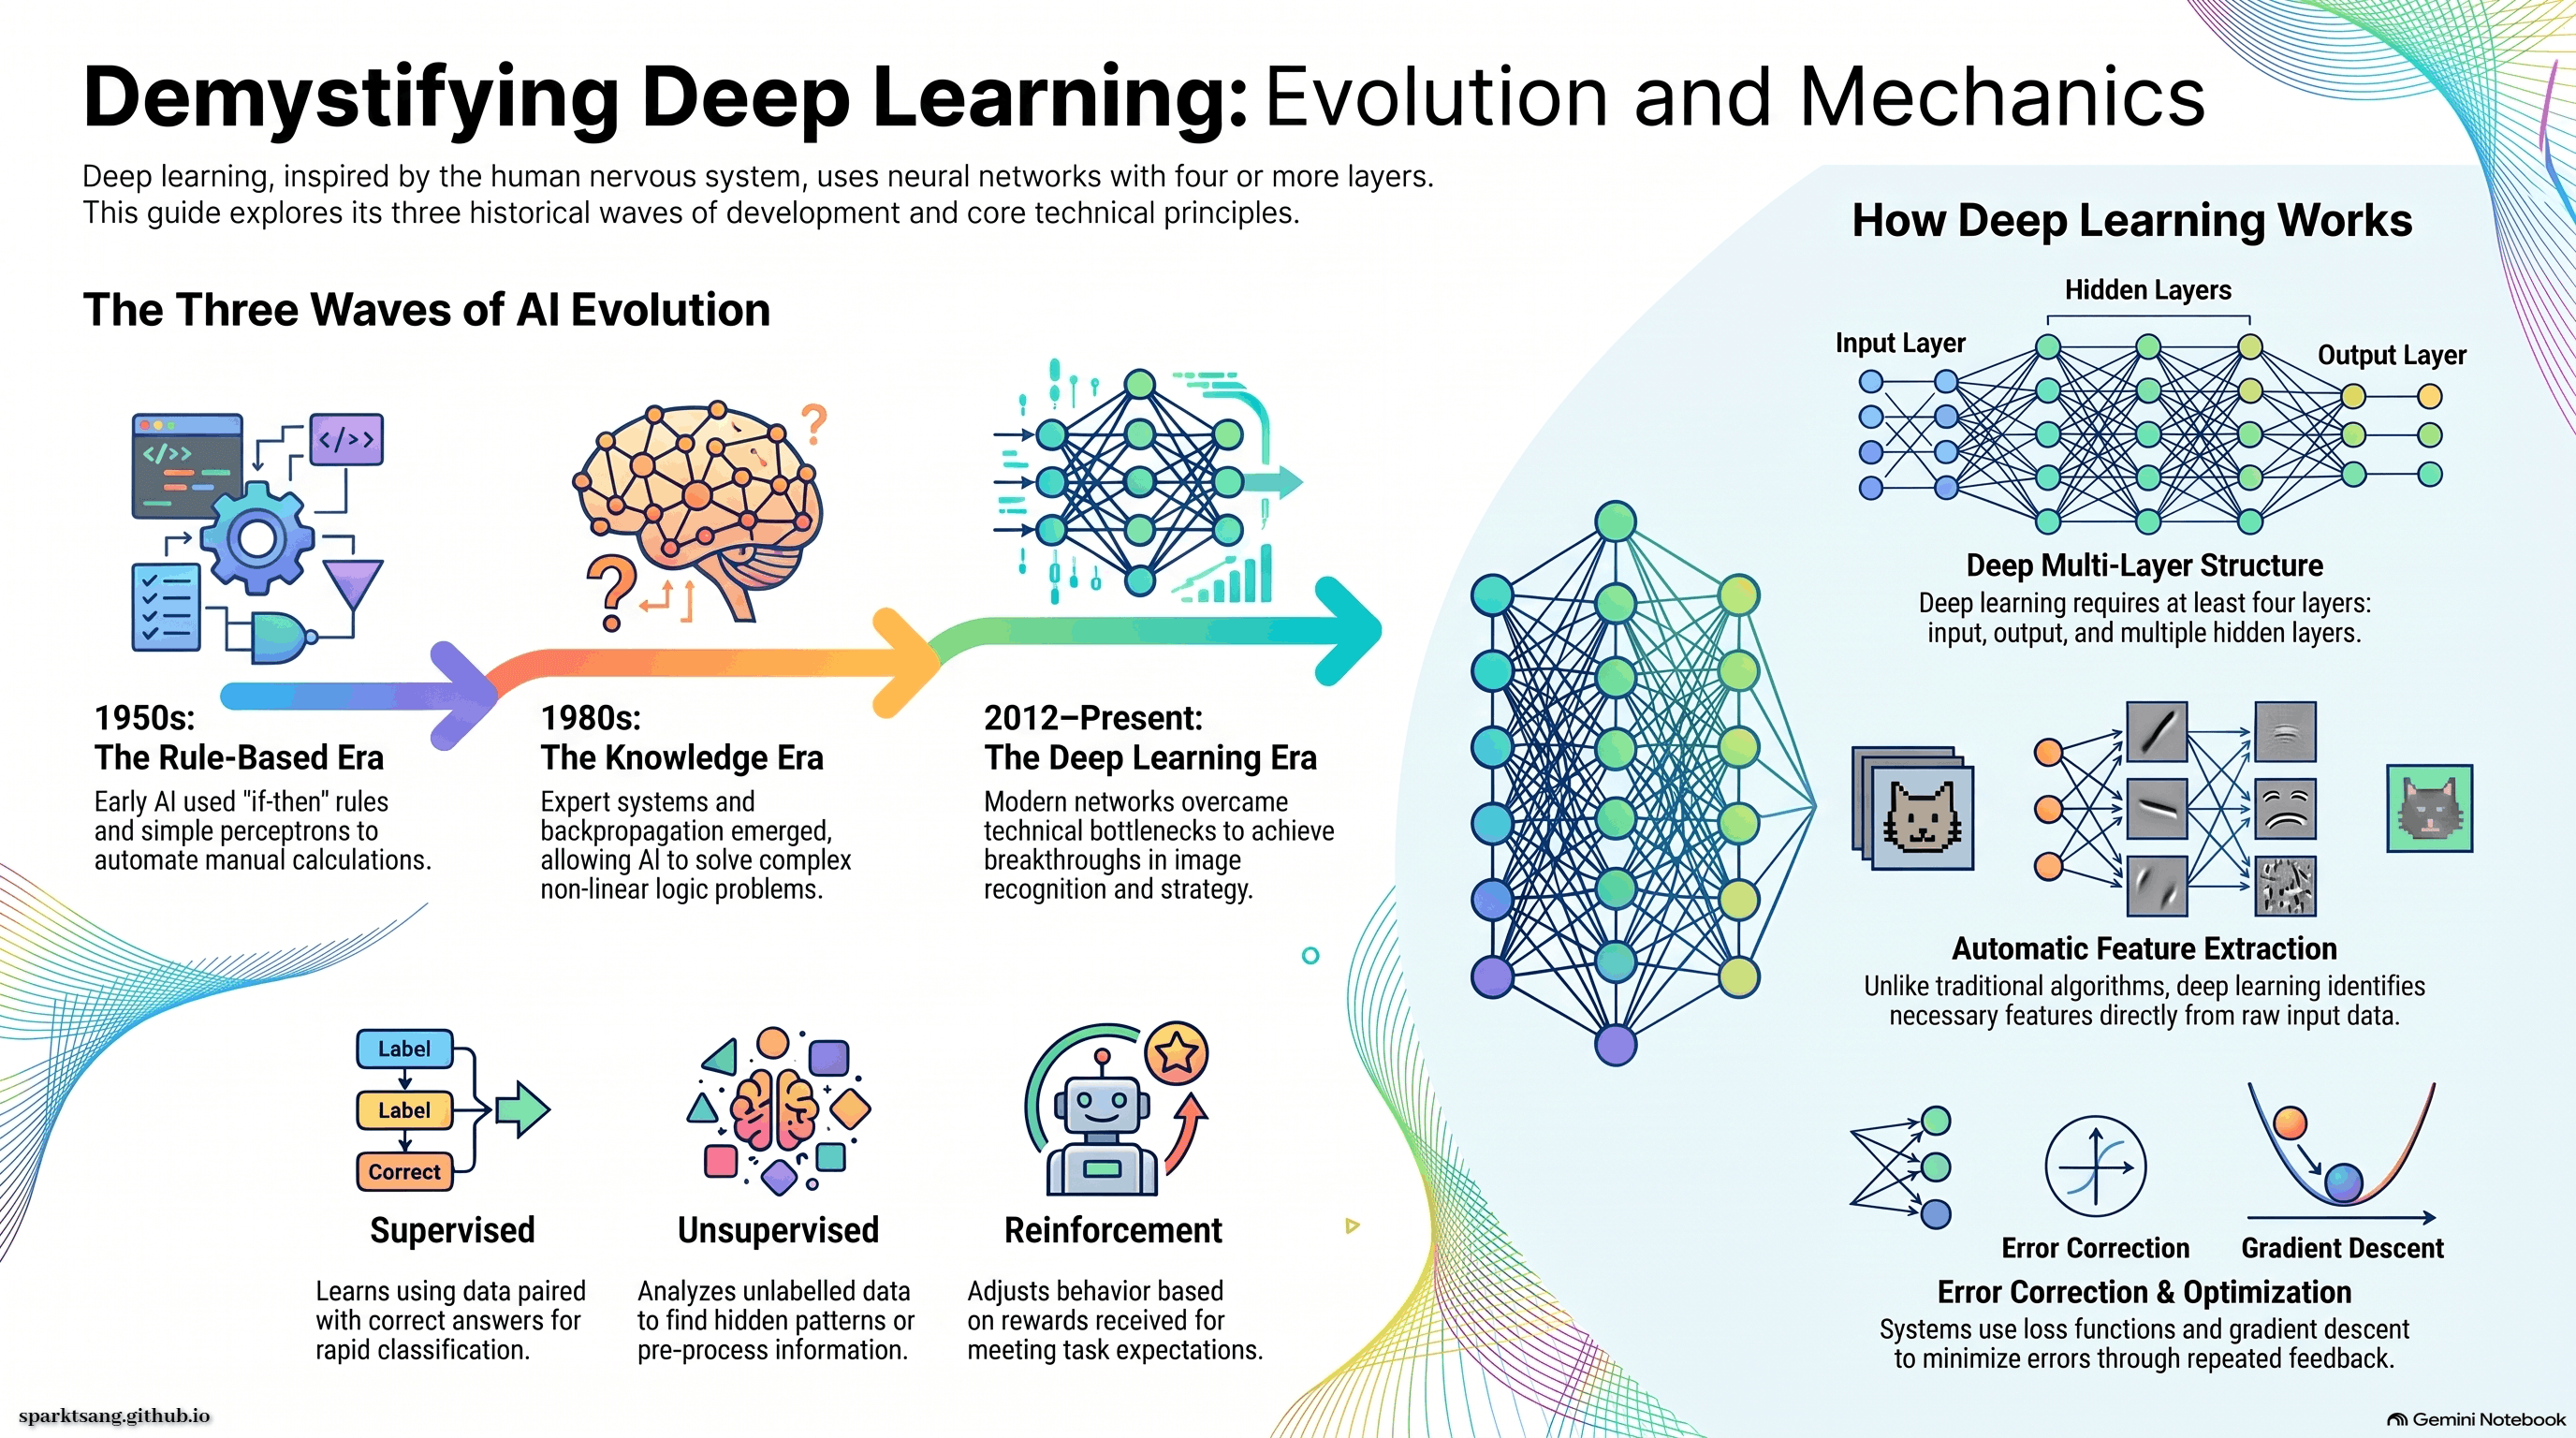
「深度學習」又稱「深層類神經網絡」,係將「類神經網絡」(仿人體神經網絡)深層化而成
等於「多層次類神經網絡」multi-layer neural networks,至少有四層以上,超過輸入層、中間層、輸出層各一層的三層,有多層中間層
「類神經網絡」係「機器學習」領域的一種演算法
五十年代的首波人工智能風潮,將手動計算改以規則自動執行,進行規則庫研究,並開發了許多自動機
規則庫:若 A 則 B 算法庫;自動機:輸入 x、輸出 y 的程序,能根據 h 的內部狀態調整,即 f (x, h),應用包括假名漢字轉換、自動販賣機
1958 年 Frank Rosenblatt 發表成為類神經網絡基礎的感知器,模仿生物神經元構造,試創應對複雜問題的智能
最初感知器只有一層,再有輸入輸出兩層、繼而加上中間三層
風潮因 Marvin Minsky 證明單純感知器無法解決互斥邏輯 XOR 問題而漸消
八十年代的次波人工智能風潮發展出大量知識庫,收錄人類經驗和知識常識實現更接近人類的人工智能 knowledge-base
也常見專用於特定領域的專門知識庫,稱為專家系統 expert system,如深藍
1967 年甘利俊一展示可用的反向傳播算法,終於在 1986 年獲 David E. Rumelhart、Geoffrey E. Hinton 等指出有效,得知單純感知無法處理的互斥邏輯問題可得解決
風潮因增加層次所導致的效能下降、梯度消失問題 vanishing gradient problem、局部最佳化問題 local optimization 漸消
九十年代 Hinton 等研究出即使類神經網絡有四層以上,也能解決梯度消失和局部最佳化問題,2012 年其團隊運用深層類神經網絡使影像辨識準確度遙遙領先,令深度學習萬眾矚目,形成第三波人工智能風潮
深度學習同時還應用於影像自動生成、自然語言生成、自動翻譯、機器人控制等,2016 年 AlphaGo 擊敗世界頂尖棋士
機器學習分為:
監督式學習 supervised learning:給予資料和正確解答來學習
除類神經網絡外,包括單純貝氏分類器、邏輯迴歸、決策樹、支援向量機
可讓電腦高速準確進行分類
非監督式學習 unsupervised learning:不給正確解答,僅從資料學習
包括 K 平均法、聚類分析與維度縮減 dimensionality reduction 領域的演算法、類神經網絡中自動編碼器的手法,係更容易理解未知資料的分析手法,或為監督式學習作預處理 pre-processing 使用
強化學習 reinforcement learning:不直指答案,對任務結果是否符合預期給予報酬,使其自行調整的學習方法
包括 Q 學習、Sarsa 法、蒙地卡羅法
機器學習無法直接讀取原始資料學習,預處理是將原始資料轉換為機器學習程式可讀取的資料格式
一般機器學習演算法需要從輸入資料抽取學習所需的必要特徵,深度學習受矚目原因之一是不需經過「特徵提取」階段已有不錯效能
學習輸入資料可分為批量學習 batch learning 與線上學習,前者將多個輸入資料統整學習,統整判斷正確與否,線上學習則逐一回饋
機器學習效能評估,包括學習時間、判定時間、與判定準確度
判定準確度標準有準確度 accuracy、損失率 loss,此外還有召回率 recall、精確度 precision、假陽性假陰性等等
對特定資料的極高準確度未必可延伸到未知資料,這現象稱為過適,對未知資料的處理效能稱為泛化能力 generalization ability
神經元係人腦基本單位,以人工神經網絡表示便如下式
\(z = f(\mu) = f\left(\sum_{i=1}^{n} (w_i x_i - h)\right); i, j\)
x = 輸入值;w = 權重系數;h = 閾值
最簡單的模型為:z = 1 if μ > h else 0,為一種階躍函數 step function,如畫出會如階級
以人工神經網絡模型進行學習的機制稱為感知器,已知等價於統計領域同樣於 1958 年發表的邏輯迴歸法,此現象甚有趣也貢獻極大
滿足某條件時輸出 1 反之 0 的函數,稱為激勵函數,有各樣如下
S 函數 Sigmoid function:\(f(\mu) = \frac{1}{1 + e^{-\mu}}\)
ReLU 函數:h (x) = x if x > 0 else 0
學習如何修改結合權重的規則有二:赫布理論 Hebbian Rule 與差量規則 Delta Rule
赫布理論:\(\Delta w_{ij} = \lambda x_j y_i$; $\Delta w_{ij}\) = 變化量
y 只會是 0 或 1,故可表示如下:Δw = λx if y triggered else 0
差量規則:答案與輸出之差越大,權重修正值越大;同時輸入值越大修正值也越大
\(w(t+1) = w(t) + \eta \delta x(t); \quad \delta = y'(t) - y(t)\)
括號內容寫在變數右下方
輸出解答正確時,\(f(w) = \lim_{n \to \infty} \frac{1}{n} \sum_{i=1}^{\infty} \left(y'(i) - y(i)\right)^2\)
以上表現將函數 f (w)最小化,此方式就像在反覆嘗試中逐漸修正
可線性分離的問題可以簡單判定,XOR 問題係一種具代表性之不可線性分離問題
David E. Rumelhart 提出將感知器階層化,先 OR 及 NAND 再將兩項 AND 產生 NAND,解決不可線性分離問題
以監督式學習為例,步驟如下:準備資料、區分輸入與正確解答、輸入類神經網絡讓其判定資料、對差異回饋、更新參數
量度誤差的,稱為損失函數 loss function,常見形式包括均方誤差與交叉熵誤差
均方:\(E = \frac{1}{2} \sum_{k} (y(k) - t(k))^2\);1/2 可打消微分後的常數 2
交叉熵:\(E = - \sum_{k} \left(t(k) \log_e(y(k))\right)\)
可用於無法簡單算差值的情況如區別貓狗
y 為機器判定;t 為正確解答
有限數據下隨意改變數值,找出最少誤差方法也可,但當組合龐大就顯得不可行
梯度法可解此問題,相當於要找世界第一高山,先登附近山頂,找更高的山,重複進行
如 y=x^2 最小值係微分後值為 0 之處,梯度法可值微分值的比較朝向下方向找,調整步伐的大小也要適當,可以學習系數η界定,這在模型直接相關參數以外,稱為「超參數」hyperparameter
梯度法有各種手法,包括最速下降法、牛頓法、隨機梯度下降法 Stochastic Gradient Descent
反向傳播算法是多層類神經網絡最有效的學習方法之一,其關鍵數學理論包括鎖鏈律
\(\frac{\partial y}{\partial x} = \left(\frac{\partial y}{\partial z}\right) \times \left(\frac{\partial z}{\partial x}\right) \approx \left(\frac{\Delta y}{\Delta z}\right) \times \left(\frac{\Delta z}{\Delta x}\right)\)
文字辨識程式例子中,以 Sequential ()選擇基本模型
Dense 定第一層,Activation 設定獎勵函數,此處用 ReLU
Dropout 將輸入隨機重置為 0 防止過適,0.2 表示兩成輸入會重置
最後輸出 Activation 用 softmax,以機率判斷何種輸出結果最可能
Dense 1 的 Param 為(784+1)×512,各層參數數量加一,係因追加了 Bias 以代替閾值,第二層(512+1)×512,最後(512+1×10)
model.compile 將準備好的學習模型編譯,轉換為機器能處理形式
loss 以 categorical_crossentropy 指定,即交叉熵作為損失基準中 Early stopping 設定學習到某種程度可提早結束的功能
training.log 輸出學習內容紀錄;model.fit 逐步更新模型參數
訓練資料經反覆學習後損失逐漸下降,但測試資料反覆學習也不太會下降(以 loss 及 val_loss 對比),顯示過適
維度的詛咒 curse of dimensionality:少量神經元學習效果未必佳,反覆學習或出現過適,但網絡複雜參數組合數量又或爆炸
卷積神經網絡是深層類神經網絡的重要核心技術之一,被設計用於電腦視覺的工作
卷積就是每次聚焦於一小區域,藉移動聚焦學習輸入整個影像
最普遍的移動是由左至右、由上至下稱為滑動 sliding
若輸入為 6×6 方形,感受野 3×3,輸出便為 4×4,即 W-F+1
人工智能研究有由上而下及由下而上型,前者以數學與計算機科學的理論觀點嘗試實現,後者模仿腦的神經細胞構造
兒童學習與發展心理學家 Alison Gopnik 解釋,人類小孩學習方法也大致分為兩類,基於既有知識來推測的由上而下,從實際現象學習的由下而上
深度學習雖於由上而下型研究中誕生,學習機制本身是由下而上
本書範例程式見:www.sotechsha.co.jp/sp/1187
閱至 152 頁,餘下內容與影像辨識及自然語言處理有關
筆記最後更新於:27/8/2020
感謝看到最後,額外送上此圖。
如需中文版圖表,不妨來函告知,我會為你特別製作。
On Errors, AI, and Correction
I make these notes myself, but this library is not produced by human effort alone. Translation, proofreading, infographic creation and review, editorial writing, and quality control all involve substantial AI assistance. I also review the work myself—but neither human judgment nor AI is infallible.
Errors may therefore exist here: mistranslations, omissions, factual mistakes, typographical errors, visual inaccuracies, or errors in my own original notes. I do not assume that my error rate is lower than that of other authors, editors, translators, or AI systems.
What matters is what happens when an error is found.
The original Markdown sources are openly available on GitHub. Anyone may propose a correction through a public edit or pull request; corrections can also be submitted by email. I will review every correction I see. If I reject one, I will give a reason, and disagreement is welcome.
When a correction is accepted, I will credit the contributor on the page and link to a website or social profile of their choice.
I do not claim infallibility. I claim openness to correction.